データ分析や統計検定の基礎を学ぶ際、多くの学習者が最初につまずきやすい概念が「復元抽出(ふくげんちゅうしゅつ)」です。「なぜ一度引いたサンプルをわざわざ袋に戻すのか」「実際のビジネスや研究でそんな面倒なことをする意味があるのか」といった疑問を抱く方も少なくありません。
復元抽出は、単なる教科書上の確率パズルにとどまらず、現代の機械学習やデータサイエンスの根幹を支える極めて強力な標本抽出理論です。この記事では、非復元抽出との決定的な違いから確率計算の仕組み、実務における活用価値までを整理して解説します。
【徹底比較】復元抽出と非復元抽出の決定的な違いと仕組み
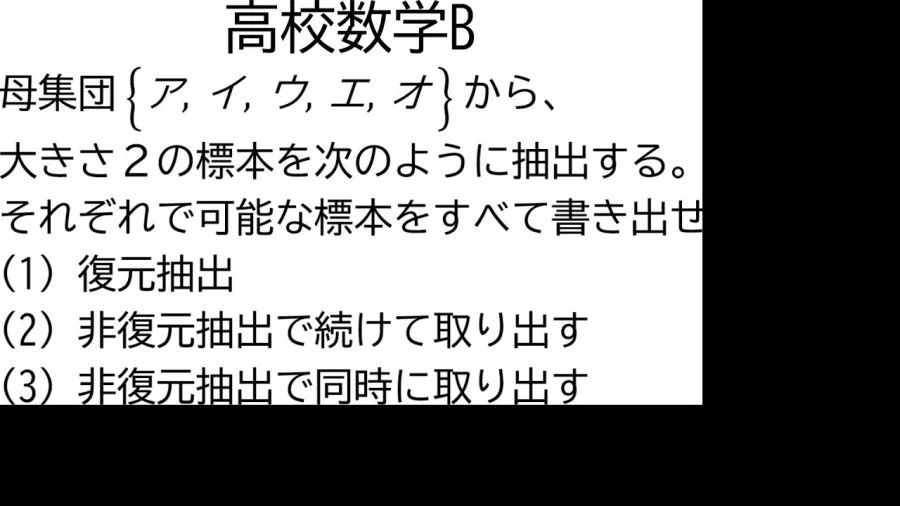
統計学におけるサンプリング手法は、大きく分けて復元抽出(sampling with replacement)と非復元抽出(sampling without replacement)の2種類に分類されます。最大の違いは、抽出した要素を「元の母集団に戻すか、戻さないか」という操作の有無にあります。
復元抽出では、1回引くごとに状態を完全にリセットするため、全体の要素数(母集団サイズ $N$)や特定の事象が起きる割合(母比率 $p$)が一切変動しません。これに対して非復元抽出は、引くたびに母集団の総数が減少し、残された要素の構成比が刻一刻と変化していきます。
| 項目 | 復元抽出(With Replacement) | 非復元抽出(Without Replacement) | 編集部の見解・実務上のポイント |
|---|---|---|---|
| 標本の戻し入れ | 毎回元の母集団へ戻す | 戻さない(除外する) | 重複を許容するかどうかの分水嶺 |
| 試行の性質 | 独立試行(前回の結果が影響しない) | 従属試行(前回の結果が影響する) | 数学的な扱いやすさを左右する最重要項目 |
| 従う確率分布 | 二項分布(離散型) | 超幾何分布(離散型) | 母集団が大きい場合は差が事実上ゼロに近似 |
| 同一要素の重複 | あり(同じデータが複数回選ばれうる) | なし(1データにつき最大1回のみ) | アンケート調査では非復元、アルゴリズムでは復元が主流 |
身近なくじ引きの具体例で理解する確率計算の違い
直感的な理解を深めるために、身近なくじ引きの例を用いて確率計算の構造を紐解いていきましょう。
「当たりが3本、ハズレが7本」入った合計10本のくじ引きの箱があるとします。この箱から2本のくじを引くとき、「2回連続で当たりを引く確率」を両方の抽出手法で計算してみます。
復元抽出の場合(独立試行)1回目の試行で当たりを引く確率は $\frac{3}{10}$ です。引いたくじを確認したあと、箱の中にくじを戻してよく混ぜます。そのため、2回目の試行でも箱の中身は「当たり3本・ハズレ7本」のまま変わりません。
各試行は互いに影響を与えない独立試行となるため、求める確率は単純な掛け算で算出できます。
$$P = \frac{3}{10} \times \frac{3}{10} = \frac{9}{100} = 9\%$$
非復元抽出の場合(従属試行)1回目に当たりを引く確率は同じく $\frac{3}{10}$ です。しかし、引いた当たりくじを箱の外に除外するため、2回目の時点では「総数が9本、当たりが2本」という状態に変化します。前の結果によって後の確率が変わる従属試行となります。
$$P = \frac{3}{10} \times \frac{2}{9} = \frac{6}{90} = \frac{1}{15} \approx 6.67\%$$
このように、非復元抽出では当たりを引くごとに残りの確率が下がっていくのに対し、復元抽出では何度引いても常に同じ「30%の壁」が維持されます。この安定性こそが、確率論や統計モデルにおいて復元抽出が重宝される理由です。
一般に知られていない盲点とネットの誤解
ウェブ上の解説記事や初学者向けのコミュニティでは、「アンケート調査や世論調査でも復元抽出が行われている」といった誤認が散見されます。しかし、標本調査の実務現場において、人間を対象としたアンケートで復元抽出を行うことは基本的にありません。
同一人物に同じ質問を2度投げかけて回答を重複させることは、調査コストの無駄であるばかりか、特定の回答者の意見が過剰に反映されるバイアス(偏り)を生む原因になるためです。そのため、一般的な社会調査や品質管理の抜取検査では非復元抽出によるランダムサンプリングが原則とされます。
では、なぜ理論上は復元抽出を前提とした数理公式が多く用いられるのでしょうか。その理由は「母集団が十分に大きい場合、非復元抽出は復元抽出と数学的に区別がつかなくなる」という統計的性質(有限母集団修正の無視)にあります。
例えば、有権者が1,000万人いる国で1,000人を抽出する場合、1人取り出したところで母集団の比率の変化は $\frac{1}{10,000,000}$ にすぎません。この微小な変化を厳密に計算する「超幾何分布」は計算負荷が極めて高いため、実務では独立試行を前提とする「二項分布(復元抽出のモデル)」として近似処理します。この理論的近似の存在が、「実務でも復元抽出をしている」という誤解を生む一因となっています。
【実態検証】復元抽出のメリット・デメリットとデータ現場のリアル
データサイエンスや機械学習の現場において、復元抽出は「近似のための便宜的な道具」から「高精度な分析を実現するための必須技術」へと進化を遂げています。
復元抽出の主なメリット- 数理モデルの単純化:確率が各ステップで固定されるため、複雑な条件付き確率を排除し、二項分布や正規分布への近似が容易になります。
- 母集団サイズ以上の標本生成が可能:元のデータセットが100件しかなくても、重複を許容することで100件やそれ以上の疑似データセットを無限に生成できます。
- 統計量の信頼区間の推定が容易:数式による厳密解の算出が困難な複雑な統計量でも、コンピュータによる再サンプリングで分布をシミュレーションできます。
- 同一標本の重複:有限かつ小さなデータセットに対して適用すると、同じデータポイントが過剰に抽出され、標本の多様性が失われるリスクがあります。
- 現実の物理的プロセスとの乖離:工場の不良品検査や医療の治験など、「一度検査した対象を再び母集団に戻して再検査する」ことが不可能なシチュエーションには直接適用できません。
復元抽出の強みを最大限に活かした代表例が、統計的推定手法であるブートストラップ法(Bootstrap Method)です。手元の限られた観測データから復元抽出を何千回も繰り返し、多数の仮想的な「再サンプリング標本」を作成することで、母集団のパラメータや予測モデルのばらつき(標準誤差)を極めて正確に推計します。
また、機械学習の決定木アルゴリズムを束ねる「ランダムフォレスト」の根幹技術であるバギング(Bootstrap Aggregating)も、この復元抽出によって各学習器に異なるデータのサブセットを割り当て、モデル全体の汎化性能を高めています。
【プロの結論】復元抽出の理解が役立つ局面・避けるべき局面
データ分析や意思決定において、復元抽出の概念を適用すべきか否かの客観的な判断基準を提示します。
復元抽出の考え方を適用すべき人・局面- 機械学習エンジニア・データサイエンティスト:バギングやアンサンブル学習、ブートストラップ信頼区間の設計を行う場合。
- 統計検定や数理統計学の学習者:二項分布、独立試行、大数の法則などの理論的前提をクリアに把握したい場合。
- サンプルサイズが小さく、数理モデルのロバスト性を検証したいアナリスト:限られた実績値から感度分析を行うシミュレーション業務。
- 実社会のフィールド調査員・マーケター:顧客アンケートや世論調査の対象を選定する場面(重複回答は調査品質を損なうため厳禁)。
- 製品の破壊検査を担当する品質管理者:検査によって対象物が消費・破壊されるため、母集団に戻す物理的操作が不可能な場面。
【復元 抽出 と は】に関するよくある質問(FAQ)
Q1:なぜ統計学では「非復元抽出」より先に「復元抽出」を学ぶのですか?
A1:数学的に扱いやすい「独立試行」を前提にできるためです。復元抽出は試行ごとに確率が変わらないため、基礎的な確率論や二項分布の公式をシンプルに理解する導入として最適だからです。
Q2:母集団が大きい場合、どちらを使っても結果は同じになりますか?
A2:実用上はほぼ同一の結果になります。母集団サイズ $N$ に対する標本サイズ $n$ の比率(サンプリング比率 $n/N$)が5%以下(場合によっては10%以下)であれば、非復元抽出であっても復元抽出(二項分布)として扱っても統計的な誤差は無視できるほど小さくなります。
Q3:ガチャやソーシャルゲームの抽選は復元抽出ですか?
A3:原則として復元抽出です。1回引くごとに排出確率がリセットされるため、何度引いても特定のキャラクターが出る確率は一定です(いわゆる「天井機能」などの救済措置が発動しない限り、独立試行となります)。一方、トレーディングカードの「パック買い」や「ボックス買い」は、封入総数が決まっているため非復元抽出に近い性質を持ちます。
「復元抽出とは何か」という問いの本質は、「各試行の独立性を担保し、確率を一定に保つための数学的アプローチ」にあります。現実のアンケート調査などの物理的オペレーションでは非復元抽出が一般的ですが、統計モデリングや機械学習のシミュレーションにおいては、復元抽出が強力な武器となります。
標本抽出の前提が「復元」か「非復元」かを見極めることは、適切な確率分布(二項分布か超幾何分布か)を選択し、データの偏りを正しく評価するための第一歩です。理論と実務の境界を正しく見極め、日々のデータハンドリングや学習に役立ててください。